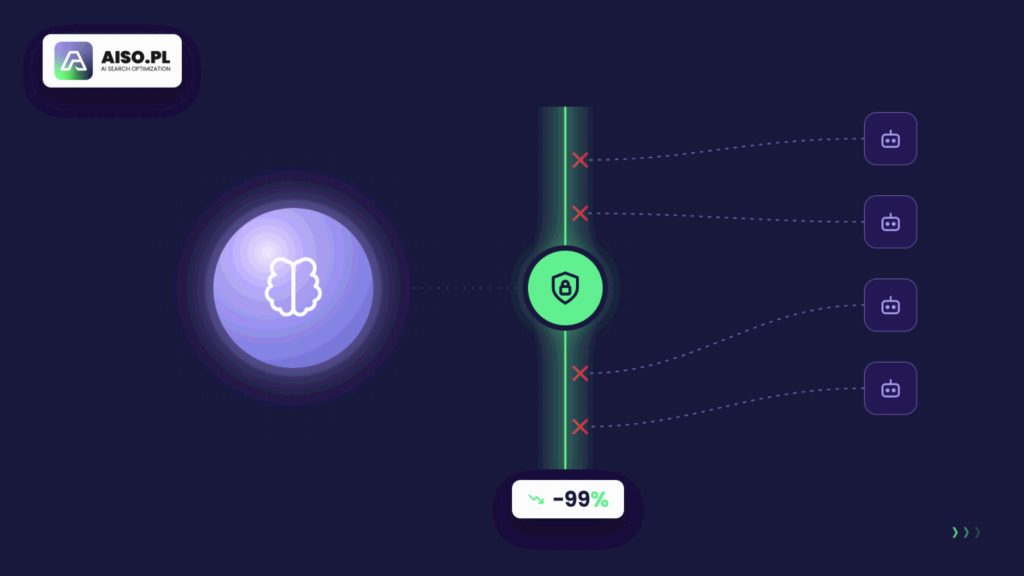
Anthropic poinformował 12 października 2026 roku o wdrożeniu nowych zabezpieczeń chroniących modele Claude przed nieautoryzowaną destylacją. Według firmy mechanizmy ograniczyły ilość danych o rozumowaniu modeli pozyskiwanych przez podmioty prowadzące takie działania o około 90–99%. Nowe rozwiązania obejmują ochronę wewnętrznego rozumowania AI, wykrywanie podejrzanych zapytań oraz blokowanie kont wykorzystywanych do masowego pozyskiwania informacji.
Co dokładnie się zmieniło?
Anthropic opublikował raport „Strengthening our defenses against distillation attacks”, przedstawiający nowe sposoby ochrony swoich najbardziej zaawansowanych modeli językowych przed nieautoryzowanym kopiowaniem ich możliwości.
Firma informuje, że po wdrożeniu dodatkowych mechanizmów bezpieczeństwa liczba tokenów wewnętrznego rozumowania Claude pozyskiwanych przez podmioty prowadzące ataki destylacyjne spadła od 10 do ponad 100 razy.
Oznacza to ograniczenie ilości przechwytywanych w ten sposób danych o około 90–99%.
Według Anthropic system wykrywania podejrzanych działań identyfikuje wszystkie techniki destylacji opisane przez firmę we wrześniowym raporcie.
To jednak wyniki wewnętrznych pomiarów. Anthropic nie twierdzi, że zabezpieczenia są skuteczne przeciwko każdej możliwej metodzie kopiowania modeli AI.
Co więcej, firma przyznaje, że spodziewa się kolejnych prób obchodzenia zabezpieczeń.
Czym jest destylacja modeli AI i dlaczego firmy chcą ją ograniczać?
Destylacja modeli AI (model distillation) to technika, w której bardziej zaawansowany model pełni funkcję nauczyciela dla innego systemu.
W praktyce odpowiedzi wygenerowane przez duży model językowy mogą zostać wykorzystane jako dane treningowe dla mniejszego lub mniej zaawansowanego modelu.
Dzięki temu drugi system może nauczyć się wykonywać określone zadania bez konieczności odtwarzania całego procesu treningowego pierwotnego modelu.
Destylacja jest znaną metodą rozwoju sztucznej inteligencji. Może służyć między innymi do tworzenia mniejszych, tańszych i bardziej wyspecjalizowanych modeli.
Sama technika nie jest więc automatycznie niedozwolona.
Problem pojawia się wtedy, gdy firmy lub inne podmioty próbują systematycznie kopiować możliwości komercyjnych modeli bez zgody ich twórców, z naruszeniem warunków korzystania z usług lub poprzez obchodzenie zabezpieczeń.
Anthropic określa takie działania jako nieautoryzowaną destylację.
Według firmy mogą one pozwalać konkurentom na odtwarzanie części zaawansowanych możliwości Claude przy znacznie niższych kosztach i krótszym czasie rozwoju.
Jak działają nowe zabezpieczenia Claude?
Anthropic opisuje trzy główne obszary ochrony przed próbami nieautoryzowanego pozyskiwania danych z modeli.
1. Ochrona wewnętrznego rozumowania modeli
Jednym z najbardziej wartościowych źródeł danych dla podmiotów prowadzących destylację są szczegółowe zapisy procesu rozumowania modelu.
Takie informacje mogą dostarczać więcej danych treningowych niż sama końcowa odpowiedź.
Anthropic rozwija więc mechanizmy ograniczające możliwość ujawniania pełnych zapisów rozumowania Claude.
Jednym z nich jest preserved thinking, które utrudnia manipulowanie wcześniejszym kontekstem modelu w celu uzyskania chronionych informacji.
Mechanizm dotyczy między innymi nowszych modeli Claude Fable i Opus oraz określonych kont korzystających z API.
Firma ograniczyła również możliwość przenoszenia chronionych zapisów rozumowania między modelami i organizacjami.
Celem jest uniemożliwienie sytuacji, w której podmiot uzyskuje dostęp do ukrytych informacji poprzez odpowiednio przygotowaną sekwencję zapytań.
2. Wykrywanie prób kopiowania możliwości Claude
Drugim elementem ochrony jest dwustopniowy system klasyfikacji zapytań.
Anthropic wykorzystuje go do identyfikowania prób wydobywania szczegółowego rozumowania modelu oraz innych zachowań charakterystycznych dla nieautoryzowanej destylacji.
System rozwijano z wykorzystaniem analizy wcześniejszych ataków oraz testów bezpieczeństwa, w których badacze próbowali obchodzić istniejące ograniczenia.
Według firmy klasyfikator osiąga poziom błędnych blokad legalnych zapytań poniżej 0,1%.
Nie oznacza to jednak, że wszystkie niepożądane zapytania są wykrywane lub że zabezpieczenia nie mogą zostać ominięte.
Anthropic zapowiada dalszą aktualizację systemu w odpowiedzi na nowe techniki wykorzystywane przez atakujących.
3. Ograniczenia i blokowanie podejrzanych kont
Trzecim elementem są mechanizmy utrudniające prowadzenie masowych kampanii pozyskiwania danych.
Anthropic analizuje aktywność kont, które wielokrotnie próbują uzyskać dostęp do chronionych informacji.
W przypadku wykrycia podejrzanych zachowań może ograniczyć liczbę zapytań, a przy powtarzających się naruszeniach zablokować konto.
Według firmy nowe zabezpieczenia doprowadziły już do zablokowania dziesiątek tysięcy kont powiązanych z kampaniami destylacyjnymi.
W wielu przypadkach blokada następowała w czasie krótszym niż dwie godziny od rozpoczęcia wykrytej kampanii.
Anthropic informuje także, że od 24 września ponownie nalicza opłaty za niektóre zapytania odrzucane przez zaawansowane mechanizmy ochrony.
Ma to podnosić koszt wielokrotnych prób obchodzenia zabezpieczeń.
Skąd wiadomo, że nowe zabezpieczenia działają?
Anthropic przedstawił dane porównujące ilość informacji pozyskiwanych przez podmioty prowadzące destylację przed wdrożeniem nowych zabezpieczeń i po ich uruchomieniu.
Według firmy liczba tokenów rozumowania Claude uzyskiwanych w takich atakach spadła od 10 do ponad 100 razy.
W praktyce oznacza to, że podmioty próbujące pozyskać chronione informacje otrzymują znacznie mniej danych niż wcześniej.
Firma przeprowadziła również eksperyment oceniający wpływ dostępu do szczegółowego rozumowania na skuteczność treningu innego modelu.
W benchmarku programistycznym SWE-bench Verified model trenowany na pełnych zapisach rozumowania osiągnął wynik 80,4%.
Gdy wykorzystano jedynie streszczone zapisy rozumowania, wynik wyniósł 71,8%.
Różnica pokazuje, dlaczego szczegółowe dane dotyczące rozumowania są atrakcyjne dla podmiotów próbujących odtworzyć możliwości zaawansowanych modeli.
Należy jednak odróżnić dwa rodzaje wyników.
Spadek liczby pozyskanych tokenów pokazuje skuteczność konkretnego mechanizmu ochrony danych.
Wyniki benchmarków pokazują natomiast, jak różne rodzaje danych treningowych wpływają na możliwości innego modelu.
Żaden z tych pomiarów samodzielnie nie dowodzi, że Claude stał się niemożliwy do skopiowania.
Dlaczego Anthropic obawia się nieautoryzowanej destylacji?
Anthropic wskazuje dwa główne zagrożenia związane z nieautoryzowanym kopiowaniem możliwości zaawansowanych modeli AI.
Pierwszym jest możliwość tworzenia systemów o dużych możliwościach bez proporcjonalnego inwestowania w zabezpieczenia.
Zdaniem firmy podmioty wykorzystujące destylację mogą odtwarzać niektóre zaawansowane zdolności modeli, pomijając część procesu oceny ryzyka i wdrażania mechanizmów bezpieczeństwa.
Drugim obszarem są kwestie własności intelektualnej, konkurencji technologicznej i bezpieczeństwa narodowego.
Anthropic opisuje wcześniejsze przypadki prób pozyskiwania możliwości Claude przez inne laboratoria rozwijające modele AI.
W raporcie wskazuje między innymi na chińską firmę Zhipu, znaną również jako Z.ai, i rozwijany przez nią model GLM-5.3.
Zarzuty dotyczące konkretnych podmiotów należy traktować jako stanowisko Anthropic, a nie jako niezależnie potwierdzone ustalenia prawne.
Spór pokazuje jednak szerszy problem rynku AI: możliwości modeli stają się zasobem gospodarczym, którego ochronie firmy poświęcają coraz więcej uwagi.
Co nowe zabezpieczenia oznaczają dla programistów i firm korzystających z API?
Nowe mechanizmy Anthropic mają znaczenie nie tylko dla potencjalnych podmiotów prowadzących destylację, ale również dla legalnych użytkowników API.
Firma przyznaje, że część zmian wymagała dostosowania istniejących integracji.
Dotyczy to między innymi sposobu obsługi zapisów rozumowania modeli i przekazywania kontekstu między zapytaniami.
Przedsiębiorstwa rozwijające własne rozwiązania AI powinny zwrócić uwagę na trzy kwestie.
Zasady wykorzystania odpowiedzi modeli
Nie każda forma wykorzystania wygenerowanych odpowiedzi do trenowania innego systemu jest dozwolona przez warunki konkretnej usługi. Przed tworzeniem własnych zbiorów treningowych warto zweryfikować zapisy umowy i politykę dostawcy API.
Stabilność integracji
Zmiany w sposobie obsługi kontekstu, zapisów rozumowania i podejrzanych zapytań mogą wymagać aktualizacji aplikacji korzystających z Claude.
Koszty i limity korzystania z API
Anthropic informuje, że określone zapytania odrzucane przez zabezpieczenia mogą być nadal rozliczane. Firmy powinny uwzględniać te zasady podczas projektowania automatyzacji oraz monitorowania kosztów.
Szczególnie ważne będzie rozróżnienie standardowych zastosowań AI, takich jak analiza dokumentów czy automatyzacja procesów, od masowego pozyskiwania danych w celu odtwarzania możliwości modelu.
Czy inni twórcy modeli AI wprowadzą podobne zabezpieczenia?
Problem destylacji dotyczy całego rynku dużych modeli językowych.
Firmy takie jak OpenAI, Google i Anthropic inwestują znaczne środki w trenowanie modeli, infrastrukturę obliczeniową i badania nad bezpieczeństwem.
Jednocześnie odpowiedzi generowane przez zaawansowane systemy mogą stanowić wartościowy materiał do rozwijania innych modeli.
Można więc oczekiwać dalszego rozwoju rozwiązań ograniczających masowe pozyskiwanie danych, wykrywanie nadużyć oraz próby obchodzenia zabezpieczeń.
Może to również wpływać na sposób projektowania komercyjnych API i warunki wykorzystania generowanych treści.
Warto jednak pamiętać, że nie każda destylacja jest działaniem nieautoryzowanym. Istnieją legalne zastosowania tej techniki, w tym trening mniejszych modeli z wykorzystaniem danych, do których deweloper posiada odpowiednie prawa.
Kluczowa pozostaje więc różnica między dozwolonym wykorzystaniem technologii a systematycznym obchodzeniem zabezpieczeń dostawcy.
Co dalej?
Anthropic zapowiada dalsze rozwijanie systemów wykrywania prób destylacji oraz reagowanie na nowe techniki wykorzystywane przez podmioty próbujące pozyskać chronione informacje.
Firma przyznaje, że nie wiadomo jeszcze, jak długo utrzyma się obecna skuteczność zabezpieczeń.
W jej ocenie będzie to ciągła rywalizacja między twórcami modeli a podmiotami szukającymi sposobów obejścia ochrony.
Dla rynku AI najważniejsze będzie ustalenie, czy podobne zabezpieczenia staną się standardem w komercyjnych interfejsach API oraz jak wpłyną na rozwój nowych modeli.
Nowe działania Anthropic pokazują, że konkurencja w sztucznej inteligencji obejmuje już nie tylko tworzenie coraz bardziej zaawansowanych modeli, ale również ochronę wiedzy i możliwości, które powstają podczas ich trenowania.
Źródła:
- Anthropic, 12.10.2026 – Strengthening our defenses against distillation attacks. Oficjalny raport z wynikami i opisem zabezpieczeń.
- Reuters, 13.10.2026 – Anthropic says new safeguards sharply reduce AI distillation attacks. Niezależne doniesienie o ogłoszeniu Anthropic.
- Anthropic – wcześniejsze badania nad atakami destylacyjnymi. Kontekst wcześniejszych prób kopiowania modeli.